自分の6年分のつぶやきに対してテキストマイニングやってみた
地獄だよ。地獄。
なにが地獄って自分のつぶやきを見返すことだよ…
2010年の1月から始めたTwitter、6年間+α、21万件のつぶやき、700万文字…
2010年、僕は高校1年生である。そのころから赤裸々に書いてきたことが全部残っていて、それをすぐにダウンロードできる。なんて世の中だ。
どうせならなにかやってみたい
テキストファイルにして15MB超のデータ。
なんかしてみたいよねえ…と思っていたところにこの記事が。
テキストマイニング(文書解析)によって、ブログ記事に寄せられるコメントを解析して、はてブ、Twitter、Yahoo!ニュースのコメントの特徴を分析した記事。
これがかなりおもしろい。
ということでテキストマイニングをやることにした。
使ったもの
つぶやきを記録しておいてくれるサービス。
公式でも全つぶやきダウンロード機能があるけど、こちらの方が使いやすかった。
上の記事でも使われていた、テキストマイニングのフリーソフト。
覚えるまでは取っつきにくいけど、めちゃくちゃおもしろい。
これが本当に無料でいいんだろうか。
年別・月別に見出しタグを付けて、その年ごとの傾向を見られるようにしてみた。
結果
特徴語は…
| 語句 | 出現回数 |
|---|---|
| 思う | 13312 |
| 福 | 11480 |
| 言う | 10481 |
| 人 | 10454 |
| 見る | 7619 |
| 荘 | 5357 |
| メール | 4334 |
| 出る | 4266 |
| 今日 | 4191 |
| 行く | 4113 |
| 今日 | 4191 |
| 行く | 4113 |
| 感じ | 3882 |
| 聞く | 3711 |
| 使う | 3625 |
| 前 | 3346 |
| 話 | 3308 |
| 今 | 3253 |
| 自分 | 3230 |
| 寝る | 2969 |
これが頻出している語である。
あまり特徴的な語はないのだけど、「福」「荘」というのが出てきている。
これは僕が福山雅治の「魂のラジオ」という番組を実況していた名残である。おそらく「メール」というのもこれの絡み。
荘「最近処女推しが結構来てますよね」
福「そのへんの方向性とかについては何も言えませんけれども」 #tamaradi— ファントム (@fphantom) 2015年3月28日
こんな感じで実況していた
その年に仲が良かった人がまるわかり
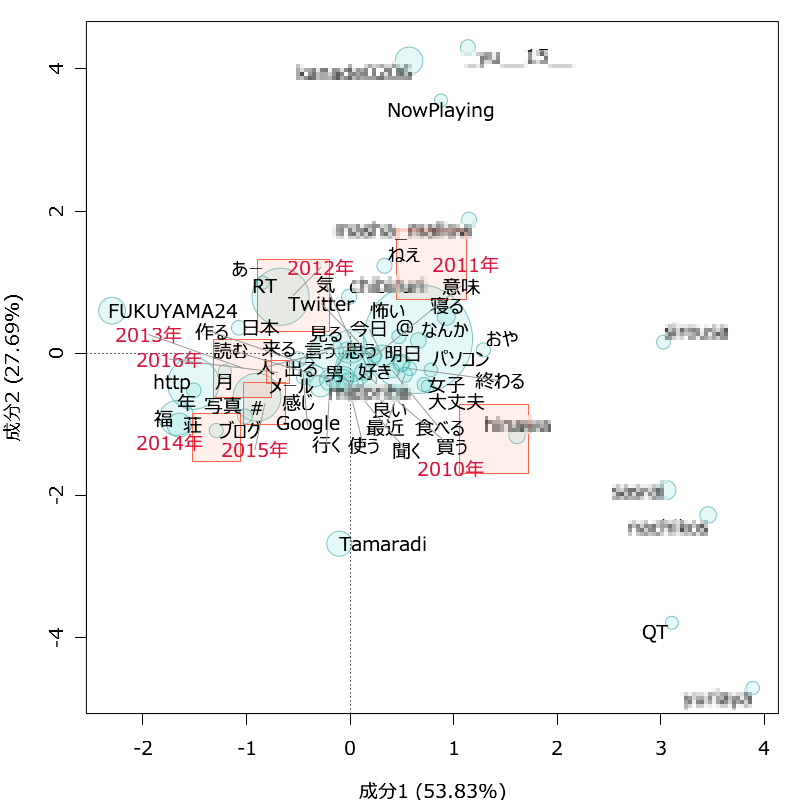
さて、対応分析である。
見方としては…
青い丸が大きいほど多く使われた言葉である。
原点(0,0)から遠ざかった位置にある言葉であるほど、特定の年にたくさんつぶやいた言葉である。
原点に対して同じ方向にある赤い枠の年に多くつぶやかれている。

例えば上の方にある「Nowplaying」は2011年に多くつぶやかれた言葉で、そこまで多く登場したわけではない、2010年と2012年でいえば2012年の方に多く登場した…そして最近はだいぶ減ってきていると言うことがわかる。
反対に若干見づらいが真ん中の方にある「思う」とか「好き」とかはまんべんなくどの年にもつぶやかれている言葉ということになる。
ちなみにモザイクがかけてある部分にはリプライであったり個人名であったりが書かれている。
さすがにそこまで公開するのはどうかと思ったんだよ…
長い付き合いの人は真ん中に、その年によく話したけどそのあと疎遠になったりアカウントが消えた人は外の方に配置されている。
懐かしさもあるけれど、なんだか寂しくなったりもする。
リプライとかRTとかハッシュタグとか
Twitterの使い方の変遷もテキストマイニングで明らかになってきた。

この画像は
- 「@」が入ったつぶやきを「リプライ」
- 「#」が入ったつぶやきを「ハッシュタグ」
- 「RT」が入ったつぶやきを「RT・QT」
というようにグループ化して、その年でどれが多いのかをまとめたものである。
当然赤くて大きな円がある年が、そのグループのつぶやきが多かった年と言うことになる。
これを眺めると、リプライは減少→増加に転じていることがわかるし、ハッシュタグをよく使っていたのは2014年ということがわかる。

これまた同じような処理をした物なのだけど、下の「あいさつ」に注目すると…
ただでさえアレだった社交性が徐々に減っていって、2016年はゼロに向かっているということが浮き彫りになってしまうのだ!
人によっては黒歴史を掘り返せるかも
いろいろと解析はしてみたのだけど、なんだかぼんやりとした結果になってしまったのである。
実は最初の目論見では下ネタの多さとかを見てみようと思ったのだけど、品行方正なことしか言っていなかった!
いやあ、残念だなあ。
そのうち特定のアーティストの歌詞とか、レビューサイトによる言葉の方向性の違いとかも解析してみようと思う。
みんなも、自分のブログとか、過去に書いていた小説とか、そういう読み返したくないモノを解析かけてみよう!
Bluesky でのコメント